
Phân loại tự động 10 loài cua bằng kiến trúc học sâu MobileNetV2 và kỹ thuật học chuyển giao
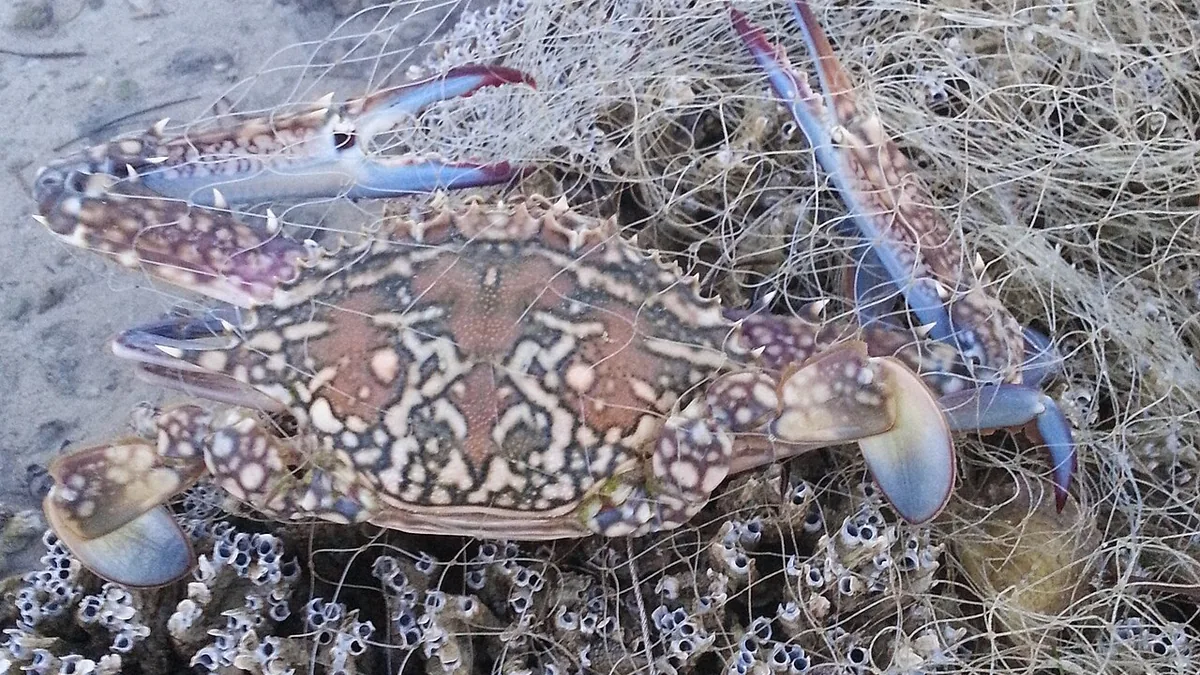
Các loài cua đóng vai trò mắt xích quan trọng trong hệ sinh thái biển ven bờ đồng thời là nguồn nguyên liệu chủ lực của ngành khai thác thủy sản và công nghiệp chế biến thực phẩm toàn cầu. Tuy nhiên, trên thực tế vận hành tại các cảng cá, nhà máy chế biến thủy sản cũng như trong các chương trình khảo sát đa dạng sinh học, việc phân loại chính xác từng loài cua thường tiêu tốn nhiều thời gian và dễ xảy ra nhầm lẫn do nhiều loài cua có đặc điểm hình thái bên ngoài, kích thước mai và màu sắc khá tương đồng nhau. Nhằm tự động hóa quy trình nhận diện và phân loại loài một cách nhanh chóng, chính xác với chi phí tính toán thấp, nhóm bốn nhà nghiên cứu gồm Karan Phadatare, Abhishek Mishra, Amit Kumar Pandey và TS. Santosh Singh đã công bố công trình nghiên cứu "Crab Species Classification Using Deep Learning Techniques" trên tạp chí khoa học quốc tế International Journal of Novel Research and Development (IJNRD) ngày 13/11/2026.
1. Bối cảnh bài toán phân loại đa loài cua trên dây chuyền chế biến và bảo tồn
Trong chuỗi cung ứng thủy sản biển, một mẻ lưới khai thác tự nhiên thường bao gồm nhiều loài cua và ghẹ khác nhau cùng lẫn lộn. Mỗi loài lại có giá trị thương mại, định mức chế biến và quy định pháp lý về kích cỡ khai thác hoặc bảo tồn hoàn toàn khác biệt (có những loài là đối tượng thương mại giá trị cao, trong khi một số loài khác thuộc diện cấm đánh bắt hoặc là sinh vật ngoại lai xâm hại cần kiểm soát). Nếu chỉ dựa vào mắt thường của công nhân phân loại thủ công trên băng chuyền tốc độ cao, tỷ lệ sai sót rất dễ gia tăng khi lao động mệt mỏi hoặc khi gặp các cá thể cua chưa trưởng thành có hình dạng gần giống nhau.
2. Quy trình tiền xử lý dữ liệu 1.921 hình ảnh của 10 loài cua
Để xây dựng một hệ thống nhận diện thị giác máy tính có khả năng phân biệt rạch ròi giữa nhiều loài cua khác nhau, nhóm tác giả đã thu thập và chuẩn hóa bộ dữ liệu gồm 1.921 hình ảnh đại diện cho 10 loài cua từ kho dữ liệu mở Roboflow Universe. Toàn bộ dữ liệu được chia theo tỷ lệ chuẩn khoa học gồm 80% dành cho tập huấn luyện (training) và 20% dành cho tập kiểm thử độc lập (validation).
Trước khi đưa vào huấn luyện mô hình trí tuệ nhân tạo, toàn bộ tập ảnh trải qua hai bước xử lý quan trọng:
- Tiền xử lý chuẩn hóa kích thước và không gian màu: Đưa tất cả hình ảnh về cùng một chuẩn độ phân giải đầu vào để mạng nơ-ron xử lý đồng nhất.
- Tăng cường dữ liệu (Data Augmentation): Áp dụng các phép biến đổi hình học như xoay góc, lật ảnh, thay đổi tỷ lệ thu phóng và điều chỉnh độ sáng nhằm mở rộng tính đa dạng của mẫu vật, giúp mô hình học sâu tránh hiện tượng học vẹt (overfitting) và nhận diện tốt ngay cả khi con cua nằm ở nhiều góc độ khác nhau dưới camera.
3. Sức mạnh của kiến trúc gọn nhẹ MobileNetV2 kết hợp học chuyển giao (Transfer Learning)
Điểm đáng chú ý trong lựa chọn giải pháp kỹ thuật của nhóm tác giả là việc sử dụng kiến trúc mạng nơ-ron tích chập siêu nhẹ MobileNetV2 kết hợp với phương pháp học chuyển giao (Transfer Learning). Trong lĩnh vực thị giác máy tính, MobileNetV2 nổi tiếng nhờ cấu trúc tích chập tách biệt theo chiều sâu (depthwise separable convolutions) và các khối thắt cổ chai đảo ngược (inverted residual blocks), giúp giảm thiểu tối đa khối lượng phép tính mà vẫn trích xuất hiệu quả các đặc trưng hình thái tinh vi của đối tượng.
Bằng cách tận dụng trọng số đã được huấn luyện trước trên các tập dữ liệu hình ảnh khổng lồ và tinh chỉnh lại các lớp phân loại cuối cùng cho bài toán 10 loài cua, phương pháp học chuyển giao giúp mô hình hội tụ nhanh chóng chỉ với 1.921 hình ảnh đầu vào. Sau quá trình huấn luyện, hiệu năng của hệ thống được đánh giá toàn diện thông qua năm bộ chỉ số chuẩn gồm: độ chính xác tổng thể (Accuracy), độ chuẩn xác (Precision), độ phủ (Recall), điểm cân bằng F1-score và ma trận nhầm lẫn (Confusion Matrix) để kiểm tra chi tiết khả năng phân biệt giữa từng cặp loài cua dễ gây nhầm lẫn.
4. Góc nhìn ứng dụng cho nhà máy chế biến thủy sản và quản lý nguồn lợi biển Việt Nam
Nghiên cứu của nhóm tác giả công bố trên tạp chí IJNRD là một gợi ý kỹ thuật rất thiết thực cho các doanh nghiệp chế biến thủy sản xuất khẩu và cơ quan quản lý nghề cá tại Việt Nam. Vì kiến trúc MobileNetV2 có dung lượng cực kỳ gọn nhẹ, mô hình này không đòi hỏi hệ thống máy chủ đắt tiền mà có thể chạy mượt mà ngay trên điện thoại thông minh phổ thông hoặc các camera thông minh giá rẻ lắp đặt dọc theo băng chuyền phân loại tại nhà máy chế biến cua ghẹ ở Kiên Giang, Cà Mau, Khánh Hòa hay Bà Rịa - Vũng Tàu.
Trên dây chuyền sản xuất, hệ thống camera tích hợp MobileNetV2 giúp tự động phân luồng nguyên liệu đầu vào theo đúng từng loài (tách riêng cua biển, ghẹ xanh, ghẹ ba chấm và các loài cua tạp), bảo đảm tính đồng nhất của từng lô hàng xuất khẩu. Đồng thời, đối với lực lượng kiểm ngư và ngư dân khai thác biển, việc cài đặt ứng dụng nhận diện loài cua bằng AI trên điện thoại giúp tra cứu tức thì các loài cua quý hiếm thuộc danh mục cấm khai thác hoặc đang trong mùa sinh sản để kịp thời thả về tự nhiên, góp phần bảo vệ nguồn lợi thủy sản ven bờ phát triển bền vững. Bạn đọc có thể xem toàn văn bài báo khoa học tại mục nguồn trích dẫn.
Nguồn trích dẫn
Phadatare, K., Mishra, A., Pandey, A. K., & Singh, S. (2026, November 13). Crab species classification using deep learning techniques. International Journal of Novel Research and Development, 11(11), a783-a787. https://ijnrd.org/viewpaperforall.php?paper=IJNRD2611082
Xem nguồn gốc
Bình luận (0)
Chưa có bình luận nào.